


SRAMニアメモリキャッシュコンピュート:市場シェア分析、業界動向と統計、成長予測(2026年~2031年)
SRAM Near-Memory Cache Compute - Market Share Analysis, Industry Trends & Statistics, Growth Forecasts (2026 - 2031)


- 発行日
- ページ情報
- 英文 170 Pages
- 納期
- 2~3営業日
- 商品コード
- 2099858
- カスタマイズ可能 お客様のご希望に応じて、既存データの加工や未掲載情報(例:国別セグメント)の追加などの対応が可能です。詳細はお問い合わせください。
- 適宜更新あり 本レポートは最新情報反映のため適宜更新し、内容構成変更を行う場合があります。ご検討の際はお問い合わせください。
- 翻訳ツール提供対象 PDF対応AI翻訳ツールの無料貸し出しサービスのご利用が可能です
概要
Mordor Intelligenceによると、SRAMニアメモリキャッシュコンピュート市場の規模は2025年に23億4,000万米ドルと評価され、2026年から2031年までの予測期間においてCAGR24.70%で拡大し、2031年には89億1,000万米ドルに達すると推定されています。
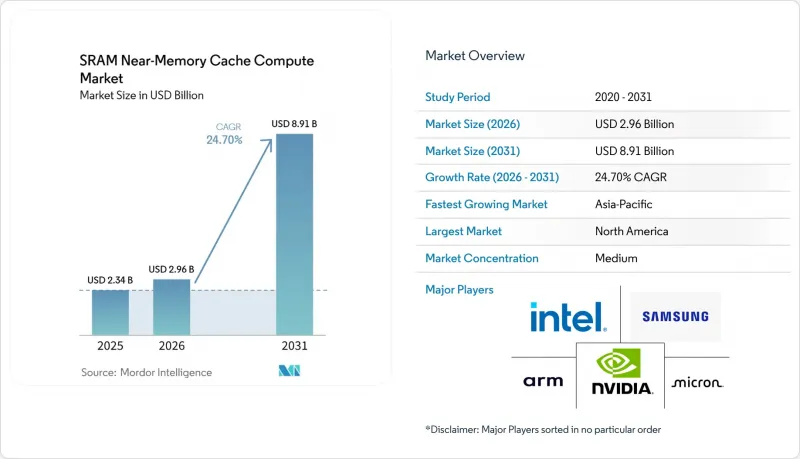
本レポートは、メモリタイプ(組み込みSRAM(eSRAM)、スタンドアロンSRAM、マルチポートSRAMなど)、プロセッサ統合(CPUキャッシュ統合、GPUキャッシュ統合など)、用途(AIトレーニング、推論、エッジAIなど)、エンドユーザー(クラウドおよびハイパースケールプロバイダー、エンタープライズデータセンターなど)、および地域別に分類されています。市場予測は金額(米ドル)ベースで提示されています。
世界のSRAMニアメモリキャッシュコンピュート市場の動向と洞察
オンチップキャッシュ近接性に対するAIアクセラレータの需要の高まり
SRAMニアメモリキャッシュ・コンピューティング市場において、AI推論はキャッシュを演算エンジンに近づけるよう推進しています。これは、展開されたモデルが実行時間の大部分を、純粋な演算処理ではなくメモリアクセスを待つことに費やしているためです。査読済みの研究によると、現代のニューラルネットワークにおけるメモリアクセスに伴うエネルギー消費の多くは、高速相互接続を介したデータ転送によって生じることが示されており、これにより、ニアメモリキャッシュの配置は二次的な設計上の選択肢ではなく、効率性を直接向上させる重要な要素となっています。SRAMが演算ブロックの隣に配置され、繰り返されるトークン演算がダイ内にとどまることで、この負荷は軽減されます。そのため、多くのAIアクセラレータにおいて、ローカル帯域幅はピーク演算密度と同様に重要視されるようになっています。NVIDIAのHopperアーキテクチャはすでにこの考え方を反映しており、AIワークロードにおける外部メモリへの繰り返しアクセスを削減するよう設計された、大規模なオンダイSRAMキャッシュを搭載しています。SRAMによるLLM推論の高速化に関する調査では、メモリ近傍でのバッファリングがデコード段階の改善につながることも示されました。デコード段階は、実稼働中の言語モデルにおいて、トークンごとの遅延が最も顕著に現れる段階です。このため、SRAMを用いたメモリ近傍キャッシュによる演算市場は、ローカルメモリの近接性を測定可能なスループットの向上につなげることができるアクセラレータプログラムを中心に展開されています。
高性能CPU、GPU、およびNPUの成長
高性能プロセッサの成長は、SRAMニアメモリキャッシュコンピュート市場の拡大を後押しし続けています。これは、追加される各演算ブロックが、ストールや外部メモリへの繰り返しアクセスを回避するためにローカルキャッシュを必要とするためです。NVIDIAは、各ストリーミングマルチプロセッサがSRAMベースのL1メモリを搭載しているため、アーキテクチャのスケールアップに伴い、オンダイキャッシュの需要も増加すると説明しています。H100は、SRAMに50MBのL2キャッシュも採用しており、これによりAI実行中に、より大規模なモデルやデータセットのフラグメントをプロセッサの近くに保持することが可能になります。Armの3nm疑似2ポートSRAMマクロの開発状況からも、IPサプライヤー各社が、固定された消費電力および面積の制約内でより高い帯域幅を実現できるようSRAM設計の最適化を進めており、これにより、より幅広い先進的なチッププログラムがサポートされることが示されています。これが重要なのは、SRAMを用いたニアメモリキャッシュによる演算市場が、データセンター向けGPUだけでなく、永続的なローカルモデル実行を必要とするCPU、NPU、エッジプロセッサにも関連しているからです。プロセッサ数やコア密度が上昇し続ける中、予測可能な応答時間を維持するための実用的な手段として、ローカルSRAMは依然として数少ない選択肢の一つとなっています。
ニアメモリ・コンピューティング統合における高い設計複雑性
ニアメモリ・コンピューティングの統合が依然として困難な理由は、SRAMアレイ、ロジックブロック、物理レイアウト、およびパッケージアーキテクチャを、個別の設計段階ではなく、一体として最適化しなければならないためです。現在のSRAMニアメモリ・キャッシュ・コンピューティング市場において、これは、先進ノードのXPUプロジェクトが、許容可能な歩留まりと熱挙動に到達するまでに、より長い検証サイクルとより高いエンジニアリング・オーバーヘッドに直面することが多いことを意味します。2026年にIEEEおよびJEDECが連携して行った分析では、アテンションカーネルによる高デューティのSRAM動作が、高密度AI設計において、局所的な熱ストレスを標準的な認定要件の想定値を超えて押し上げる恐れがあると警告しています。同分析では、このストレスが、持続的な動作負荷下におけるバイアス温度不安定性(BTI)やサイレントデータ破損のリスク上昇につながると指摘されています。また、最先端のロジックおよび高密度SRAMノードは、TSMCの最先端ロードマップを含む少数の製造エコシステムに集中しているため、ファウンダリへの依存も障壁となっています。これらの制約により、SRAMニアメモリキャッシュコンピュート市場において、新しいプロジェクトを迅速に拡大できるチームの数は限られています。
セグメント分析
2025年、組み込みSRAMはSRAMニアメモリキャッシュコンピュート市場の73.84%を占め、メモリタイプ別市場セグメンテーションにおいて依然として圧倒的な主導的地位を維持しました。その優位性は、同じプロセスフローでロジックと共製造されることに起因しており、これによりパッケージのオーバーヘッドが排除され、高速なローカルメモリを必要とする先進的なSoCにとってデフォルトの選択肢となっています。Marvell社の2nmカスタムeSRAMは、このセグメントが基本的なキャッシュ機能の枠を超えて進化していることを示しています。最大6Gbの高速オンチップメモリを搭載し、同等の密度における標準SRAMと比較して待機電力を66%低減し、2nm XPU設計においてダイ面積を15%削減しています。これは重要な点です。なぜなら、eSRAMはすでにモバイルNPU、自動車用プロセッサ、データセンター用アクセラレータに広く組み込まれており、設計上の改善は極めて広範な導入ベース全体に波及するからです。実際、これにより、他のメモリバリエーションが改良されても、組み込みSRAMはSRAMベースのニアメモリキャッシュ・コンピューティング市場において確固たる地位を築くことになります。
高密度SRAMは、2031年までCAGR25.49%で拡大すると予測されており、メモリタイプの中で最も成長が著しいサブセグメントとなる見込みです。5nmデジタルSRAMを用いたインメモリコンピューティングマクロに関するIEEEの調査では、5.67Mb/mm²という密度が報告されており、これは将来の設計における高密度なローカルモデルストレージにとって重要なベンチマークとなります。スタンドアロン型SRAMは、L2キャッシュや最終レベルキャッシュの構造、およびネットワーク用半導体において依然として重要な役割を果たしており、これらの分野では、繰り返し行われるランダムアクセスにおいて、低レイテンシのローカルメモリが依然として有利に働きます。また、スループットのボトルネックを生じさせることなく、並列演算クラスタ全体で同時読み取りおよび書き込みアクセスを必要とするプロセッサにおいても、マルチポートSRAMの重要性が高まっています。これらを総合すると、SRAMニアメモリキャッシュ演算業界は、標準的なキャッシュブロックから、さまざまな帯域幅やデータフローのニーズに対応した、より専門化されたメモリ形態へと広がりつつあることがわかります。
AIアクセラレータのキャッシュ統合は、2025年のSRAMニアメモリキャッシュコンピュート市場規模において43.17%のシェアを占め、2031年までCAGR25.43%で成長すると予測されています。この2つの分野が主導的な役割を果たしている理由は、専用のトレーニングおよび推論用チップが、ほとんどの汎用プロセッサよりもダイ面積の大きな割合をSRAMに割り当てているためです。その結果、このセグメントは現在、より広範なSRAMニアメモリキャッシュコンピュート市場の大部分において、SRAMコンパイラ、ファウンダリチューニング、およびキャッシュ階層設計のペースを決定づけています。NVIDIAのHopperアーキテクチャはその好例であり、AI実行中のHBMへの繰り返しアクセスを削減するよう設計された、SRAM内の50MBのL2キャッシュを搭載しています。アクセラレータプログラムが拡大するにつれ、キャッシュ密度から電力予算設定に至るまで、幅広い上流設計の選択肢がそれに伴って変化していきます。
GPUキャッシュの統合は、各ストリーミングマルチプロセッサが効率的なデータ再利用を維持するためにローカルなSRAMベースのL1メモリに依存しているため、依然として主要な出荷数量の源泉となっています。一方、CPUキャッシュの統合は、特にホストプロセッサが依然としてオーケストレーション、制御、およびメモリ調整を管理しているAIサーバープラットフォームにおいて、より安定した出荷数量基盤を提供しています。Armの3nm疑似2ポートSRAMマクロの開発は、IPエコシステムが依然として厳しい面積および消費電力の制約の中で帯域幅を向上させ続けていることを示しており、この分野における継続的な最適化を支えています。ネットワークおよびエッジASICへの統合は異なる使用事例に対応しており、SRAMはシステムエッジにおけるパケットバッファリング、リアルタイム推論、および低遅延制御を支援します。これにより、プロセッサへの統合は、急速に進化するアクセラレータコアと、GPU、CPU、および専用ASICにまたがる安定したサポート基盤との間でバランスが取れています。
地域別分析
2025年、北米はSRAMニアメモリキャッシュコンピュート市場の42.77%を占め、設計および導入において最大の地域拠点となっています。この地域は、SRAMニアメモリキャッシュコンピュート市場の製品優先順位を決定づける、主要なチップ設計会社、プラットフォームベンダー、およびハイパースケールAI購入企業が集中しているという利点があります。これにより、ウエハー製造が他地域で行われる場合でも、北米はキャッシュアーキテクチャ、ソフトウェア要件、およびパッケージングの選択に対して強い影響力を持っています。主な制約は、最先端のSRAMを多用するノードにおいてアジアのファウンダリへの依存が続いていることであり、これにより、海外製造能力に紐づく供給リスクが残っています。
アジア太平洋地域は、SRAMニアメモリキャッシュコンピュート市場において、2031年までに25.58%という最も高いCAGRで推移すると予測されています。同地域は、台湾のファウンダリの深み、韓国のメモリ製造力、そして複数の国家エコシステムにまたがるAIシリコン設計業務の拡大を兼ね備えています。TSMCのN2プロセスは2025年第4四半期に量産を開始し、約0.019MB/mm²のSRAM密度を実現しました。これにより、先進ノードにおける高密度なキャッシュ統合が可能となります。ニアメモリアーキテクチャは、許容できないほどのダイ面積の増加を招くことなく高密度なローカルSRAMに依存しているため、この供給上の優位性は重要です。より先進ノードの設計が構想段階から量産へと移行するにつれ、アジア太平洋地域は、SRAMニアメモリ・キャッシュ・コンピューティング市場において、アーキテクチャ上の需要を出荷可能なシリコンへと転換する主要な生産拠点であり続けています。
SRAMニアメモリキャッシュコンピュート市場における欧州の役割は、メモリの信頼性とローカルAIの応答性が重要な自動車および組み込み処理分野と最も密接に関連しています。NXP、STマイクロエレクトロニクス、ルネサスは、それぞれ自動車およびエッジ使用事例向けに、AIアクセラレーションとオンチップSRAMを組み合わせた製品を市場に投入しています。南米、中東・アフリカは依然として導入の初期段階にあり、需要は自国でのチップ設計というよりは、通信、クラウドの展開、産業の近代化に関連しています。これにより、北米が設計需要を牽引し、アジア太平洋地域が製造の勢いをリードし、欧州が自動車分野での専門性を加える一方で、南米、中東・アフリカは徐々に基盤を築いていくという地域ごとの特徴が生まれています。
その他の特典:
- エクセル形式の市場予測(ME)シート
- 3ヶ月間のアナリストによるサポート
よくあるご質問
目次
第1章 イントロダクション
- 調査の前提条件と市場の定義
- 調査範囲
第2章 調査手法
第3章 エグゼクティブサマリー
第4章 市場情勢
- 市場概要
- 市場促進要因
- オンチップキャッシュへの近接性を求めるAIアクセラレータの需要の高まり
- 高性能CPU、GPU、およびNPUの成長
- エネルギー効率の高いデータ転送量の削減への移行
- 先進SoCにおける組み込みSRAMの利用拡大
- エッジコンピューティングおよびリアルタイム分析ワークロードの拡大
- SRAMを多用する設計に対するファウンダリおよびIPエコシステムの対応状況
- 市場抑制要因
- ニアメモリ・コンピューティング統合における設計の複雑さの高さ
- ソフトウェア・ツールチェーンおよびプログラム可能性のサポートが限定的
- SRAMの面積コストおよび高密度化の制約と、代替メモリとの比較
- 高密度コンピューティングダイにおける熱および電力管理の課題
- 業界バリューチェーン分析
- マクロ経済要因が市場に与える影響
- 技術展望
- 規制情勢
- ポーターのファイブフォース分析
第5章 市場規模と成長予測
- メモリタイプ別
- 組み込みSRAM(eSRAM)
- スタンドアロンSRAM
- マルチポートSRAM
- 高密度SRAM
- プロセッサ統合別
- CPUキャッシュの統合
- GPUキャッシュの統合
- AIアクセラレータのキャッシュ統合
- ネットワークおよびエッジASICの統合
- 用途別
- AIトレーニング
- AI推論
- HPC
- ネットワーク
- エッジAI
- 自動車
- エンドユーザー別
- クラウドおよびハイパースケールプロバイダー
- エンタープライズデータセンター
- 自動車メーカーおよびティア1サプライヤー
- 産業企業
- 通信機器プロバイダー
- 地域別
- 北米
- 米国
- カナダ
- メキシコ
- 欧州
- ドイツ
- 英国
- フランス
- イタリア
- その他の欧州諸国
- アジア太平洋
- 中国
- 日本
- 韓国
- 台湾
- インド
- その他のアジア太平洋諸国
- 南米
- 中東・アフリカ
- 北米
第6章 競合情勢
- 市場集中度
- 戦略的動向
- Vendor Positioning Analysis
- 企業プロファイル
- NVIDIA Corporation
- Intel Corporation
- Advanced Micro Devices, Inc.
- Arm Holdings plc
- Samsung Electronics Co., Ltd.
- SK hynix Inc.
- Micron Technology, Inc.
- Taiwan Semiconductor Manufacturing Company Limited
- Qualcomm Incorporated
- Broadcom Inc.
- Marvell Technology, Inc.
- Synopsys, Inc.
- Cadence Design Systems, Inc.
- IBM Corporation
- MediaTek Inc.
- NXP Semiconductors N.V.
- STMicroelectronics N.V.
- Renesas Electronics Corporation
- Bosch Sensortec GmbH
- Cerebras Systems, Inc.
第7章 市場機会と将来の展望
- 発行日
- 発行
- Mordor Intelligence
- ページ情報
- 英文 170 Pages
- 納期
- 2~3営業日