


ハイブリッドクラウドAIワークロードオーケストレーション:市場シェア分析、業界動向と統計、成長予測(2026年~2031年)
Hybrid Cloud AI Workload Orchestration - Market Share Analysis, Industry Trends & Statistics, Growth Forecasts (2026 - 2031)


- 発行日
- ページ情報
- 英文 170 Pages
- 納期
- 2~3営業日
- 商品コード
- 2154497
- カスタマイズ可能 お客様のご希望に応じて、既存データの加工や未掲載情報(例:国別セグメント)の追加などの対応が可能です。詳細はお問い合わせください。
- 適宜更新あり 本レポートは最新情報反映のため適宜更新し、内容構成変更を行う場合があります。ご検討の際はお問い合わせください。
- 翻訳ツール提供対象 PDF対応AI翻訳ツールの無料貸し出しサービスのご利用が可能です
概要
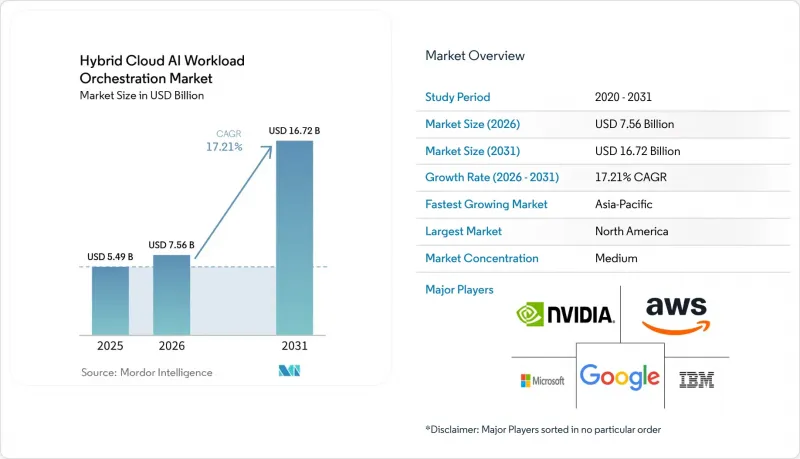
Mordor Intelligenceによると、ハイブリッドクラウドAIワークロードオーケストレーション市場の規模は、2025年の54億9,000万米ドルから2026年には75億6,000万米ドルへと拡大し、2031年までに167億2,000万米ドルに達すると予想されており、2026年から2031年にかけてCAGR17.21%で拡大すると見込まれています。
世界のハイブリッドクラウドAIワークロードオーケストレーション市場の動向と洞察
LLMのトレーニングおよび推論の展開の加速
大規模言語モデル(LLM)のトレーニングと推論は、ハイブリッドAIインフラストラクチャの運用要件を変えつつあります。これは、本番システムがもはや固定されたサーバー群上で単一のモデルを実行するものではなく、コンピューティング、ストレージ、ネットワークのタスクが連携して実行される一連のプロセスとなっているためです。本番システムでは、プライベート環境とパブリック環境をまたいで、プリフィルノード、デコードノード、KVキャッシュ層を管理する必要がありますが、これらの環境では、容量条件、パフォーマンス要件、データ管理方針が異なることが多々あります。静的なKubernetes構成では、リソース全体にわたってリアルタイムの意思決定を行い、基盤となるインフラストラクチャの実際の状態を反映する専用のオーケストレーション層がなければ、これらの段階を効率的に管理することはできません。AWSは、NVIDIA Dynamo、vLLM、およびマルチノードクラスター間での高帯域幅KVキャッシュの移動を活用する、Amazon SageMaker HyperPod向けの分散型推論機能を導入しました。Google Cloudの報告によると、GKE搭載のManaged Lustreでは、KVキャッシュを高性能な並列ファイルシステムに移行した結果、Llama-3.3-70Bの推論に必要なGPU時間要件を約60%削減できました。こうした多段階アーキテクチャにより、ハイブリッドクラウドAIワークロードオーケストレーション市場の役割は、従来のジョブスケジューリングから、リソースを大量に消費するワークロードコンポーネントの動的なルーティングへと広がっています。
GPU利用率とコンピューティングコストの最適化が不可欠
GPUの利用率は、大規模なAIインフラを運用する組織にとって、中心的な財務上の懸念事項となっています。これは、未使用のアクセラレータ容量が新しいワークロードの制約となる一方で、ハードウェアを自社で所有している場合でも、クラウド契約を通じて利用している場合でも、高い固定コストが発生するためです。未使用の容量を抱える組織は、インフラコストの増加、コンピューティングへのアクセス遅延、変化するモデル要件への対応における柔軟性の低下、そして限られたGPU容量をどこに割り当てるべきかという内部での議論の難航といった課題に直面しています。富士通の報告によると、2024年には75%以上の組織で、ピーク負荷時のGPU利用率が70%を下回っていました。レッドハットは、IBM Velaクラスターの導入事例を紹介しました。この事例では、Kueueの導入により、GPU利用率がベースラインの30%未満から、アクティブ負荷時において90%近くまで向上しました。マイクロソフトは、NVIDIA Run:aiがAzure Kubernetes Serviceの導入において、動的なGPU分割とクォータ共有をサポートしていると述べています。ハイブリッドクラウドAIワークロードオーケストレーション市場は、スケジューリングプラットフォームが、容量の回収、支出の管理、および社内のチームやテナント間で希少なコンピューティングリソースへのより公平なアクセスを実現するツールとして評価されていることから、恩恵を受けています。
異種ハードウェアとクラウドAPIの相互運用性のギャップ
GPUベンダー、クラウドスケジューラー、Kubernetesツール間で共通のAPIレイヤーが存在しないことは、ハイブリッドAI環境の導入コストと複雑さを増大させます。マルチクラウドAIチームは、ビジネス上の目標が単一で一貫性のある運用モデルである場合でも、AWS Elastic Fabric Adapter、Google Kubernetes Engineの推論ツール、およびRun:aiを搭載したAzure Kubernetes Serviceに対して、それぞれ個別の統合が必要になる可能性があります。これらの統合では、利用可能なすべての環境について、可用性、コスト、炭素強度、および特定のポリシー条件を自動的に評価する共通のワークロード抽象化が提供されません。ベンダー固有の通信ライブラリは、異なるアクセラレータタイプの分散利用をさらに複雑にします。なぜなら、ハードウェアファミリー間でデータを移動したり、ジョブを調整したりするには、カスタム実装作業が必要になる場合があるためです。この制約により、供給の回復力、購入の柔軟性、およびコスト管理の観点から魅力的であるにもかかわらず、マルチベンダーGPUプールの導入が遅れる可能性があります。ハイブリッドクラウドAIワークロードオーケストレーション市場は、小規模なベンダーには、クラウド間、Kubernetesディストリビューション、アクセラレータプラットフォーム、そして変化し続けるプロバイダーのインターフェースにわたる統合を維持するためのエンジニアリングリソースが不足している可能性があるため、さらなる圧力に直面しています。
セグメント分析
2025年には、ソフトウェアが収益の62.72%を占めました。これは、物理的なコンピューティング環境の上位にあるガバナンス、スケジューリング、およびポリシー適用レイヤーに対して、顧客が価値を置いていることを反映しています。ハイブリッドクラウドAIワークロードオーケストレーション市場において、これらのレイヤーは、ワークロードの受け入れ、アクセラレータの割り当て、ID制御、監査記録、およびテナントがクラウドとローカルシステムにまたがる共有インフラストラクチャをどのように使用するかを規定するルールなど、本来であれば別々の製品に分散していた機能を統合します。この統合により、ツール間の引き継ぎを最小限に抑え、本来なら個別に管理されていたワークロードに対しても、管理者が共通の運用ルールを適用できるようになります。また、定期的なライセンスおよびサブスクリプションモデルは、ハードウェアの購入サイクルとの直接的な結びつきが弱いため、プラットフォームベンダーにとってより持続可能な収益基盤を支えるものとなります。レッドハットは2026年2月、LinuxやKubernetesから、ガバナンスが適用されたAIモデル、エージェント、アプリケーションにまで及ぶ統合プラットフォームとして、「Red Hat AI Enterprise」をリリースしました。このリリースは、プロバイダーが従来別々だったインフラストラクチャ製品をより広範な契約に統合し、調達を簡素化するとともに、顧客1人あたりのソフトウェア収益を増加させている実態を示しています。
サービス市場は、2026年から2031年にかけてCAGR17.61%で拡大すると予測されています。その背景には、多くの社内ITチームが当初、独自では管理しきれない導入および運用上の要件が存在します。統合されたコントロールプレーンを本番環境に導入するには、データ所在地、ワークロードのプロファイル、クラスター構成、クラウド契約、アクセスルール、セキュリティ制御、および継続的なパフォーマンス要件の評価が必要となる場合があります。プロフェッショナルサービスはアーキテクチャを構築し、これらの運用要素を統合することができ、一方、マネージドサービスは稼働開始後もパフォーマンス、コストの可視性、および運用規律を維持することができます。組織は、社内のノウハウを蓄積する間、サービス依存度の高いプロジェクトから開始し、チームがより多くの運用業務を担うようになるにつれて、支出のより大きな割合をソフトウェアライセンスやプラットフォームのサブスクリプションへと移行させていくことがよくあります。したがって、ハイブリッドクラウドAIワークロードオーケストレーション業界は、ソフトウェアの価格決定力と、顧客が環境を構成、運用、改善するための外部専門知識に対する継続的な需要を組み合わせたものとなっています。
2025年には、クラウドが収益の57.28%を占めました。これは、弾力的なGPU容量、広範な地域での利用可能性、および企業がAI環境のあらゆる部分を自社で保有する必要性を軽減するマネージドインフラストラクチャサービスに支えられたものです。ハイブリッドクラウドAIワークロードオーケストレーション市場は、厳格なデータ居住要件を必要としないワークロード、一時的な容量ニーズ、および多額の初期ハードウェア投資を伴わずに大規模なGPUフリートにアクセスする必要があるワークロードにおいて、引き続きクラウド環境に依存しています。また、プロジェクトが小規模なパイロット段階から大規模な本番ワークロードへと移行する際、クラウドを活用することで、コンピューティングリソースの拡張に必要な時間を短縮できます。ハイパースケーラー各社は、クラスター管理や分散インフラに関する深い社内専門知識を持たない顧客向けに、日常的な管理負担を軽減できるマネージドサービスも提供しています。ロシュ社は、米国および欧州のハイブリッドクラウド環境とオンプレミス環境に、3,500台以上のNVIDIA Blackwell GPUを導入しました。この導入事例は、上級ユーザーが必ずしもクラウドとプライベートインフラのどちらか一方を選択するわけではないことを示しています。むしろ、データ、パフォーマンス、コンプライアンスのニーズに最適なロケーションと容量モデルをワークロードに適用できるよう、両者を組み合わせる場合もあるのです。
規制対象のユーザーが機密性の高いワークロードに対する管理権限をより強く保持し、管轄上の義務に従わなければならないため、オンプレミス展開は2026年から2031年にかけてCAGR17.59%で拡大すると予測されています。トレーニングデータ、推論パイプライン、監査記録は、同じ広域リージョン内でクラウドリソースが利用可能であっても、定義された場所に保持する必要がある場合があります。専用のローカルインフラストラクチャを利用することで、購入者はNVIDIA、AMD、Intelのハードウェアに供給元を分散させつつ、データ準備、微調整、および機密性の高い推論タスクに対する制御を維持することも可能になります。HPEは2026年、自社のAI Factoryポートフォリオにおいて、NVIDIA Mission Controlソフトウェア、Run:ai、およびNVIDIA Dynamoへの対応を追加しました。ハイブリッドクラウドAIワークロードオーケストレーション市場は、この組み合わせモデルによって形成されています。このモデルでは、プライベート環境での管理によってデータ保持やガバナンスのニーズが満たされ、一方でクラウドの伸縮性によって、同一の運用環境内でピーク時のコンピューティング要件に対応します。
地域別分析
2025年、北米は売上高の38.92%を占め、ハイブリッドクラウドAIワークロードオーケストレーション市場において同地域が首位に立っています。この地域には、ハイパースケーラー、専用GPUクラウドプロバイダー、調査能力、そしてすでにパイロットプロジェクトの段階を超え、本格的な運用段階に移行している企業のAIプログラムが融合しています。米国は、AWS、Microsoft Azure、Google Cloudが運営する大規模な管理型GPUフリートや、高負荷なAIワークロードに対応する専門インフラプロバイダーを通じて、需要の大部分を牽引しています。NVIDIAは2026年1月にCoreWeaveに20億米ドルを投資し、両社は2030年までに5ギガワットを超えるAIファクトリーの容量を計画しています。カナダとメキシコでは、米国のハイパースケーラーのインフラを基盤とした国境を越えたハイブリッドアーキテクチャを活用できる金融サービスや製造業のユーザーから、さらなる需要が生まれています。
アジア太平洋地域は、2026年から2031年にかけてCAGR 18.23%で拡大すると予測されており、ハイブリッドクラウドAIワークロードオーケストレーション市場において最も急速に成長する地域となる見込みです。政府主導の国家AIプログラム、企業での導入拡大、および各国のスーパーコンピューティングへの投資が、中国、日本、インド、韓国における需要を牽引しています。各国のデータ居住地ポリシーにより、ハイブリッド制御層の重要性が高まっています。これは、パブリッククラウドの容量を、機密性の高いワークロードを保持する国内インフラと併用して運用する必要が生じる可能性があるためです。日本の「AI戦略」やインドの「IndiaAIミッション」は、各国のデータ居住地フレームワークの下で運用される国内AIインフラへの公的資金の投入を指示しています。東南アジアおよびオーストラリアでは、現地のデータ要件を管理し、商用および調査用ワークロードの両方に対応する容量を求める金融サービス、医療、政府機関からの需要が加わっています。
欧州は、ハイブリッドクラウドAIワークロードオーケストレーション市場において大きなシェアを占めており、ドイツ、フランス、英国が主導的な役割を果たしています。これらの国の製薬、自動車、金融サービス企業は、EU全体および各国のデータ規制の両方を満たす、管理されたAI環境を必要としています。EU AI法、一般データ保護規則(GDPR)、EUデータ法、およびデジタルオペレーショナルレジリエンス法により、ガバナンス、監査可能性、データ居住性機能を備えたシステムへの調達が促進されています。中東では、サウジアラビアやアラブ首長国連邦(UAE)における国家主導のAIプログラムを通じて勢いを増していますが、南米およびアフリカは依然として初期段階の地域であり、需要はブラジル、コロンビア、南アフリカ、ナイジェリアに集中しています。
その他の特典:
- エクセル形式の市場予測(ME)シート
- 3ヶ月間のアナリストによるサポート
よくあるご質問
目次
第1章 イントロダクション
- 調査の前提条件と市場の定義
- 調査範囲
第2章 調査手法
第3章 エグゼクティブサマリー
第4章 市場情勢
- 市場概要
- 市場促進要因
- LLMのトレーニングおよび推論の導入の加速
- GPUの利用率と演算コストの最適化が不可欠です
- ハイブリッドデータレジデンシーと主権AIの要件
- 異種アクセラレータ間における分散型AIスケジューリング
- エージェント型AIOpsおよびポリシー主導型自動化の導入
- エネルギー効率を考慮したスケジューリングと持続可能なAIインフラ
- 市場抑制要因
- ハードウェアの異種混在とクラウドAPIの相互運用性のギャップ
- AIインフラオーケストレーションの専門家の不足
- マルチテナントGPUにおけるセキュリティと分離の複雑性
- ハイブリッド制御プレーン間における移行の摩擦
- マクロ経済要因が市場に与える影響
- 業界バリューチェーン分析
- 規制情勢
- 技術展望
- ポーターのファイブフォース分析
第5章 市場規模と成長予測
- コンポーネント別
- ソフトウェア
- サービス
- 導入環境別
- クラウド
- オンプレミス
- 用途別
- GPUのスケジューリングと割り当て
- ワークロードの配置と移行
- クラスタ管理とオートスケーリング
- ガバナンス、マルチテナント、およびポリシーの適用
- モニタリング、可観測性、およびコスト最適化
- エンドユーザー別
- クラウドサービスプロバイダーおよびGPU-as-a-Serviceプロバイダー
- ITおよびテクノロジー企業
- BFSI
- ヘルスケア・ライフサイエンス
- 製造業および自動車業界
- 政府、防衛、調査機関
- 小売、消費者、メディア
- 組織規模別
- 大企業
- 中小企業
- 地域別
- 北米
- 米国
- カナダ
- メキシコ
- 南米
- ブラジル
- アルゼンチン
- コロンビア
- その他の南米諸国
- 欧州
- ドイツ
- 英国
- フランス
- イタリア
- その他の欧州諸国
- アジア太平洋
- 中国
- 日本
- インド
- 韓国
- オーストラリア
- 東南アジア
- その他のアジア太平洋諸国
- 中東
- サウジアラビア
- アラブ首長国連邦
- トルコ
- その他の中東諸国
- アフリカ
- 南アフリカ
- ナイジェリア
- その他のアフリカ諸国
- 北米
第6章 競合情勢
- 市場集中度
- 戦略的動向
- 市場シェア分析
- 企業プロファイル
- NVIDIA Corporation
- Amazon Web Services, Inc.
- Microsoft Corporation
- Google LLC
- International Business Machines Corporation
- Hewlett Packard Enterprise Company
- Red Hat, Inc.
- Broadcom Inc.
- VMware LLC
- Nutanix, Inc.
- CloudBolt Software, Inc.
- Morpheus Data LLC
- Flexera Software LLC
- Scalr Inc.
- Mirantis, Inc.
- Platform9 Systems, Inc.
- Anyscale, Inc.
- CoreWeave, Inc.
- Rafay Systems, Inc.
- Hopsworks AB
- ClearML Ltd.
- Domino Data Lab, Inc.
- Lambda Labs, Inc.
- RunPod, Inc.
- Vast.ai, Inc.
- Modal Labs, Inc.
- Nscale Limited
- Vultr Holdings Corporation
第7章 市場機会と将来の展望



