


ディスアグリゲーテッドGPU:市場シェア分析、業界動向と統計、成長予測(2026年~2031年)
Disaggregated GPU - Market Share Analysis, Industry Trends & Statistics, Growth Forecasts (2026 - 2031)


- 発行日
- ページ情報
- 英文 172 Pages
- 納期
- 2~3営業日
- 商品コード
- 2098497
- カスタマイズ可能 お客様のご希望に応じて、既存データの加工や未掲載情報(例:国別セグメント)の追加などの対応が可能です。詳細はお問い合わせください。
- 適宜更新あり 本レポートは最新情報反映のため適宜更新し、内容構成変更を行う場合があります。ご検討の際はお問い合わせください。
- 翻訳ツール提供対象 PDF対応AI翻訳ツールの無料貸し出しサービスのご利用が可能です
概要
Mordor Intelligenceによると、ディスアグリゲーテッドGPU市場の規模は、2025年に39億7,000万米ドル、2026年に53億4,000万米ドルとなり、2031年までに226億3,000万米ドルに達すると予測されており、2026年から2031年にかけてCAGR33.48%で成長すると見込まれています。
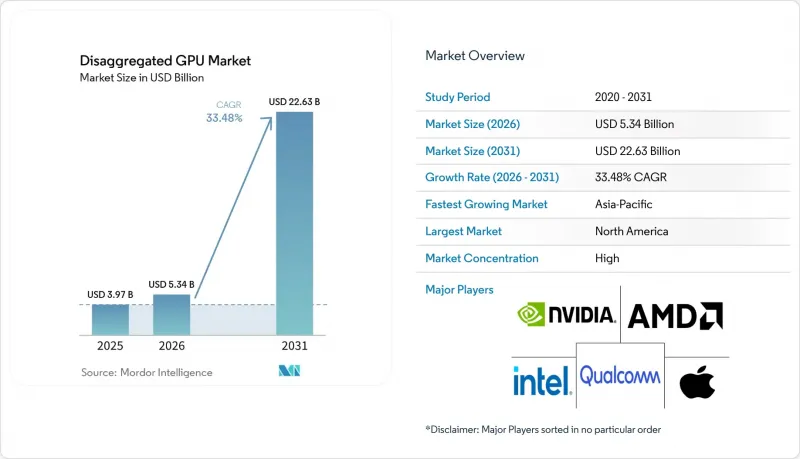
本レポートは、コンポーネント別(ハードウェア、ソフトウェアなど)、アクセラレータータイプ別(PCIeベースのディスアグリゲーション、NVLink/NVSwitchベースのディスアグリゲーションなど)、展開モード別(オンプレミス、クラウド)、用途(AIおよびハイパフォーマンスコンピューティングなど)、エンドユーザー(ハイパースケールクラウドプロバイダー、クラウドサービスプロバイダーなど)、および地域ごとに分類されています。市場予測は金額(米ドル)ベースで提示されています。
世界のディスアグリゲーテッドGPU市場の動向と洞察
AIトレーニングクラスターにおけるGPUプーリングの需要の高まり
大規模なAIトレーニングの実行では、多数の物理GPUを単一の共有論理リソースとして扱うことが不可欠となっているため、ディスアグリゲーテッドGPU市場はGPUプーリングから直接的な後押しを受けています。NVIDIAの第6世代NVLinkは、GPUあたり1.8 TB/sの双方向帯域幅を実現し、NVLink Switchシステムは単一のNVL72ラック内で72個のGPUをサポートすることで、合計130 TB/sのドメイン内帯域幅を提供し、かつて隣接するラックを孤立した演算アイランドに分断していた通信上の制約を軽減しました。この変化は、1兆パラメータ規模のモデルにとって重要です。なぜなら、メモリと帯域幅への負荷が、単一のノード内ではなく、トレーニングクラスタ全体に及ぶようになったためです。また、分散型GPU市場では、アイドル状態の容量をアクティブなワークロードに、はるかに迅速に割り当てられるようなアーキテクチャが提案されています。エージェント型AIは、さらなる需要の層を加えています。プリフィル段階は計算負荷が高く、デコード段階はメモリ帯域幅の負荷が高いため、このパターンでは、遅延を伴う手動のスケジューリングサイクルではなく、数秒単位でプールを再割り当てする必要があります。AWSは、Blackwellノード上でllm-dとNVIDIA Inference Xfer Libraryを使用して、この運用モデルを実稼働環境で実証しました。そこでは、分散型推論により、高い同時実行数においてスループットが70%向上しました。
演算とメモリの分離型アーキテクチャへの移行
また、オペレーターが演算とローカルメモリを分離し、メモリ容量をプール化されたインフラストラクチャ層として扱うにつれ、ディスアグリゲートされたGPU市場も進展しています。『Tsinghua Science and Technology』誌に掲載された調査では、CXLベースのメモリディスアグリゲーションがインテリジェント・コンピューティング・センターにとって重要なアーキテクチャ上の進歩であると説明されています。これは、共有メモリプールに、標準的なロードおよびストア操作を通じて複数の演算ノードからアクセスできるためです。ByteDanceの研究者たちは、この方向性をさらに発展させ、MicronのCXL Type-3カードとTITAN-II CXLスイッチで構成された768 GBの共有メモリプールを実証しました。これにより、NVIDIA H100 GPUを搭載した3つのノード間で、アプリケーションコードの変更なしにGPU間の集合的な通信が可能になりました。これが重要なのは、ロングコンテキスト推論が100万トークンを超え、KVキャッシュの需要が各アクセラレータで利用可能なHBM容量を上回るため、GPUフリート全体を置き換えるよりも、プールされたメモリを追加する方が現実的だからです。したがって、ディスアグリゲートされたGPU市場にとって、CXLは技術的な選択肢としてだけでなく、シリコンの全面的な更新を強いることなく、より多くのメモリ容量を必要とする事業者にとって経済的な道筋としてもメリットをもたらします。
高度な相互接続およびファブリック統合の複雑さ
ディスアグリゲーテッドGPU市場は依然として大きな統合の障壁に直面しています。その理由は、多くの導入事例において、単一のクラスター内でNVLink、PCIe、InfiniBand、イーサネット、およびCXLを連携させる必要があるためです。HotNets 2025で発表された調査によると、ホスト内の異種相互接続にわたる効果的なパス管理には、PCIeスイッチ、GPUファブリックコントローラ、RDMA NIC、およびイーサネットスイッチの同時連携が必要ですが、現在のソフトウェアスタックではその複雑さを完全に抽象化できていません。NVIDIAの「NVLink Fusion」は、MediaTek、Marvell、Qualcomm、富士通製のカスタムCPUがNVIDIA製GPUとネイティブに接続できるようにすることで、この問題の一部を軽減しましたが、この動きは、完全に中立なマルチベンダー・ファブリックを構築するのではなく、独自仕様の経路を拡大する結果となりました。Ultra Accelerator Link規格は、ベンダー中立の代替手段を提供することを目的としていますが、情報によると、量産ハードウェアの登場は2026年後半まで見込まれておらず、広範な導入は2027年までずれ込む可能性が高いとのことです。また、分散型GPU市場は、中国において地域的な相互運用性の壁に直面しています。同国では、国内のアクセラレータエコシステムが互換性のない通信プロトコルを使用しているため、通信事業者が大規模に実現できる実用的なリソースプール化のメリットが制限されています。
セグメント分析
2025年のディスアグリゲーテッドGPU市場において、ハードウェアが81.32%を占めました。これは、相互接続ファブリック、スイッチトレイ、メモリモジュール、およびラックスケールのコンピューティングシステムにかかる初期費用の高さを反映したものです。各Vera Rubin NVL72ラックには、72個のBlackwell GPU、36個のVera CPU、NVLinkスイッチチップ、BlueField-4 DPU、およびSpectrum-Xイーサネットネットワークが統合され、単一のファブリックベースの資本ユニットを形成しています。このため、ディスアグリゲーテッドGPU市場における初期投資は、大規模なハイパースケール調達サイクルに集中しています。この調達モデルが重要となる理由は、購入者が単体のカードやサーバーを購入しているのではなく、単一の導入プロジェクト内で演算、ネットワーク、管理機能を統合したプラットフォームを採用しているからです。したがって、ディスアグリゲーテッドGPU市場は、特にハイパースケーラーがノード単位での段階的な追加ではなく、フルラック単位で新たなAI処理能力を構築していることから、現段階ではハードウェア寄りの収益構成を示しています。サービスは依然として構成要素の中で最も小さな割合を占めていますが、統合、マネージド運用、およびGPU-as-a-Service(GPUaaS)の提供は、システムインテグレーターや専門のクラウド事業者にとって、依然として魅力的な利益率の可能性を秘めています。
ディスアグリゲーテッドGPU市場において、2026年から2031年にかけてソフトウェア分野が34.08%という最も高いCAGRで推移すると予測されています。これは、オーケストレーション層、分離ツール、推論フレームワークが、各GPUから事業者が得られる価値をますます決定づけるようになるためです。NVIDIA Dynamoは、プレフィルとデコードの割り当てを分離することで、工場規模での稼働率を向上させました。この設計は、llm-dなどのオープンソースの代替ソリューションが、エンタープライズ展開において今後追随すべき基準点を確立しました。これにより、ハードウェアの更新サイクルが鈍化したり、既存のファブリックがそのまま残ったりする場合でも、ソフトウェアのアップグレードを継続できるため、ディスアグリゲーテッドGPU業界の収益パターンが変化することになります。2024年および2025年にディスアグリゲート型ハードウェアを導入した事業者は、物理的な相互接続資産を置き換える前に、新たなオーケストレーション層を追加する可能性が高いです。これにより、ラックの交換時期への依存度が低い、継続的なソフトウェア収益の道が開かれます。長期的には、たとえハードウェアが絶対的な支出の主軸であり続けたとしても、こうした動向により、ディスアグリゲーテッドGPU市場においてソフトウェアがより大きな役割を果たすようになるはずです。
NVLink/NVSwitchベースのディスアグリゲーションは、2025年にディスアグリゲーテッドGPU市場シェアの44.21%を占めており、これはAIトレーニングファブリックにおけるNVIDIAの強固な地位と、密結合型GPU通信に対する既存の選好を反映しています。第6世代NVLinkは2024年にGPUあたり1.8 TB/sの帯域幅を実現し、さらに新しいNVLink Switchシステムでは、72基のGPU間で全対全通信が可能となり、合計130 TB/sの帯域幅を提供しました。これにより、高密度なローカル通信を必要とするスケールアップクラスター向けに、ディスアグリゲーテッドGPU市場に高性能な選択肢がもたらされました。PCIeベースのディスアグリゲーションは、多くのマルチGPUシステムにおいてベースラインファブリックとしての確固たる役割を維持し、独自の技術への依存度を低く抑えつつ、幅広い互換性を提供しました。InfiniBandやイーサネットベースのアプローチは、スケールアウト環境において引き続き重要であり、特にイーサネットは、既存のネットワーク投資を基盤として大規模なAIクラスターを拡張したいと考える事業者にとって、その重要性を高めました。このような分岐は、ディスアグリゲーテッドGPU市場が単一の汎用ファブリックへと向かっているのではなく、パフォーマンス、オープン性、および導入済みのインフラストラクチャのそれぞれが最終的なアーキテクチャに影響を与える階層型モデルへと向かっていることを意味します。
CXLベースのディスアグリゲーションは、CXL 3.0のメモリプーリングと、PCIe 7.0の物理層を通じて帯域幅を128 GT/sへと倍増させ、総スループットを大幅に向上させるバンドルポートを導入したCXL 4.0仕様に支えられ、2031年までCAGR34.46%で拡大すると予測されています。『Tsinghua Science and Technology』誌の調査によると、CXLメモリのディスアグリゲーションとGPU演算のディスアグリゲーションは、スタックの異なる層に対応していることが示されており、これは、将来のディスアグリゲーテッドGPU市場における導入において、両者のどちらか一方を選択することを強いるのではなく、これらを組み合わせる方向に向かうことを示唆しています。サムスン電子は、MarvellおよびLiquid AIと共同で、GPUメモリを拡張するための「Pangea CXLメモリプラットフォーム」を開発しています。これは、HBMの制限によって推論のバッチサイズやワーキングコンテキストの深さが制約される可能性があるためです。実際には、NVLinkはラック内のGPU間での緊密に結合された通信に適している一方、CXLはノード間やより広範なシステムドメインにわたるメモリ容量の拡張とメモリ共有を実現します。この相補的な関係により、ディスアグリゲートされたGPU市場は、本番環境のクラスターですでに確立されている高帯域幅のGPUファブリックの役割を損なうことなく、より構成可能なアーキテクチャへと成熟していくはずです。
地域別分析
2025年、北米は52.71%のシェアを占め、ディスアグリゲーテッドGPU市場において最大の地域シェアを記録しました。これは、米国におけるハイパースケール構築の進展ぶりを反映しています。AWS、Google Cloud、Microsoft Azure、およびOracle Cloud Infrastructureは、いずれも2026年下半期にNVIDIA Vera Rubin NVL72システムを導入する企業として挙げられており、こうした主要購入企業の集中が、同地域におけるディスアグリゲーテッドGPU市場の基盤を引き続き支えています。また、北米は、充実したハードウェアエコシステム、大規模なAI研究活動、そしてCoreWeave、Lambda、Nscaleなどのプロバイダーを含む成熟したGPUクラウドレイヤーの恩恵も受けています。2025年9月、NVIDIAがIntelと提携し、NVLinkおよびx86ベースのカスタムAIデータセンター用CPUを開発したことで、地域のサプライチェーンが強化され、オーケストレーション用CPUとGPUファブリックの統合がさらに進みました。カナダは、米国のハイパースケール需要への近接性と有利な電力コストにより支援を補完していますが、南米は依然として初期段階にあり、広範なオンプレミス展開というよりは、ブラジルやコロンビアのハイパースケール・アベイラビリティゾーンに依存する傾向が強いです。
欧州は、ディスアグリゲーテッドGPU市場において有意義ではあるもの比較的小さなシェアを占めており、ユーザーからの回答によると、ドイツ、英国、フランスが主な導入拠点となっています。欧州連合(EU)のエネルギー効率指令では、IT負荷が500 kWを超えるデータセンターに対して電力使用効率(PUE)の報告が義務付けられており、これにより、より効率的なディスアグリゲート型設計が促進されるとともに、事業者は施設のパフォーマンスを測定可能な形で実証することが求められています。ドイツの自動車および精密製造産業は、デジタルツインや物理シミュレーションのワークロードに対する需要を支えており、こうした分野では、固定のサーバー割り当てよりも、プール化されたインフラを通じてバーストコンピューティングの導入を正当化しやすい状況にあります。英国は活発なGPUクラウド分野を通じて貢献しており、一方、フランスとイタリアは、ディスアグリゲーテッドGPU容量を組み込んだ国家主導のAIコンピューティングプログラムを拡大しています。
アジア太平洋地域は、2026年から2031年にかけてCAGR34.39%で拡大すると予測されており、予測期間中、ディスアグリゲーテッドGPU市場において同地域が最も高い成長率を示すと見込まれています。この地域の成長を牽引しているのは、中国のハイパースケールAI投資、韓国の垂直統合型メモリサプライチェーン、日本の製造・自動化ニーズ、そしてインドやシンガポールにおける公共AIインフラプログラムです。中国は、独自の相互接続アプローチを基盤とした国内のディスアグリゲート型アーキテクチャを構築しており、これにより、中国のスタックがディスアグリゲーテッドGPU市場の他の地域で使用されているものとは異なる、地域ごとに分かれた構造が形成されています。韓国は、SKハイニックスがHBM3eの生産において占める地位の恩恵を受けており、これにより国内の事業者はメモリサブシステムへの早期アクセスを確保でき、データセンターへの資本投入の迅速化が促進されています。インドも、政府主導のAIイニシアチブやハイパースケール・クラウド・ゾーンの拡大に伴い、急速に動き出しています。一方、中東およびアフリカは開発の初期段階にとどまっていますが、UAEやサウジアラビアにおける国家主導のAI投資プログラムからの支援を得つつあります。
その他の特典:
- エクセル形式の市場予測(ME)シート
- 3ヶ月間のアナリストサポート
よくあるご質問
目次
第1章 イントロダクション
- 調査の前提条件と市場の定義
- 調査範囲
第2章 調査手法
第3章 エグゼクティブサマリー
第4章 市場情勢
- 市場概要
- 市場促進要因
- AIトレーニングクラスターにおけるGPUプーリングの需要の高まり
- 演算とメモリの分離型アーキテクチャへの移行
- ハイパースケールおよびクラウドネイティブAIインフラの拡大
- 資源の細分化による電力および熱効率の向上
- マルチテナント型GPU割り当てによるフリートの稼働率向上
- モジュラー型データセンターアーキテクチャにおけるアップグレードサイクルの短縮
- 市場抑制要因
- 高度な相互接続およびファブリック統合の複雑さ
- GPUスタック間のソフトウェアオーケストレーションの断片化
- レガシーデータセンターの改修における資本集約度
- リモートメモリおよび分散アクセスにおけるレイテンシのトレードオフ
- 業界バリューチェーン分析
- 規制情勢
- 技術展望
- ポーターのファイブフォース分析
- マクロ経済要因が市場に与える影響
第5章 市場規模と成長予測
- コンポーネント別
- ハードウェア
- ソフトウェア
- サービス
- アクセラレータータイプ別
- PCIeベースのディスアグリゲーション
- NVLink/NVSwitchベースのディスアグリゲーション
- イーサネット・ファブリックベースのディスアグリゲーション
- InfiniBandファブリックベースのディスアグリゲーション
- CXLベースのディスアグリゲーション
- 展開モデル別
- オンプレミス
- クラウドベース
- 用途別
- AIおよびハイパフォーマンスコンピューティング
- データアナリティクス
- デジタルツインとシミュレーション
- レンダリングおよび可視化
- 科学研究
- エンドユーザー別
- ハイパースケール・クラウド・プロバイダー
- クラウドサービスプロバイダー
- 企業
- 政府・防衛機関
- 研究・学術機関
- 通信プロバイダー
- 地域別
- 北米
- 米国
- カナダ
- メキシコ
- 欧州
- ドイツ
- 英国
- フランス
- イタリア
- その他の欧州諸国
- アジア太平洋
- 中国
- 日本
- 韓国
- インド
- 東南アジア
- その他のアジア太平洋諸国
- 南米
- 中東・アフリカ
- 北米
第6章 競合情勢
- 市場集中度
- 戦略的動向
- 市場ポジショニング分析
- 企業プロファイル
- NVIDIA Corporation
- Advanced Micro Devices, Inc.
- Intel Corporation
- Qualcomm Incorporated
- Apple Inc.
- Samsung Electronics Co., Ltd.
- MediaTek Inc.
- Arm Holdings plc
- Imagination Technologies Limited
- Hewlett Packard Enterprise Company
- Dell Technologies Inc.
- Super Micro Computer, Inc.
- Lenovo Group Limited
- ASUSTeK Computer Inc.
- Gigabyte Technology Co., Ltd.
- Micro-Star International Co., Ltd.
- Alibaba Group Holding Limited
- Tencent Holdings Limited
- Amazon.com, Inc.
- Microsoft Corporation
第7章 市場機会と将来の展望
- 発行日
- 発行
- Mordor Intelligence
- ページ情報
- 英文 172 Pages
- 納期
- 2~3営業日

