


AIデータ準備サービス:市場シェア分析、業界動向と統計、成長予測(2026年~2031年)
AI Data Readiness Services - Market Share Analysis, Industry Trends & Statistics, Growth Forecasts (2026 - 2031)


- 発行日
- ページ情報
- 英文 181 Pages
- 納期
- 2~3営業日
- 商品コード
- 2154332
- カスタマイズ可能 お客様のご希望に応じて、既存データの加工や未掲載情報(例:国別セグメント)の追加などの対応が可能です。詳細はお問い合わせください。
- 適宜更新あり 本レポートは最新情報反映のため適宜更新し、内容構成変更を行う場合があります。ご検討の際はお問い合わせください。
- 翻訳ツール提供対象 PDF対応AI翻訳ツールの無料貸し出しサービスのご利用が可能です
目次・概要・図表を含むサンプルPDF(数ページ~数十ページ)を、担当者からEメールでお送りします。費用はかかりません。
概要
Mordor Intelligenceによると、AIデータ準備サービス市場の規模は、2025年の252億1,000万米ドルから2026年には312億9,000万米ドルへと拡大し、2031年までに859億1,000万米ドルに達すると予想されており、2026年から2031年にかけてCAGR22.38%で成長すると見込まれています。
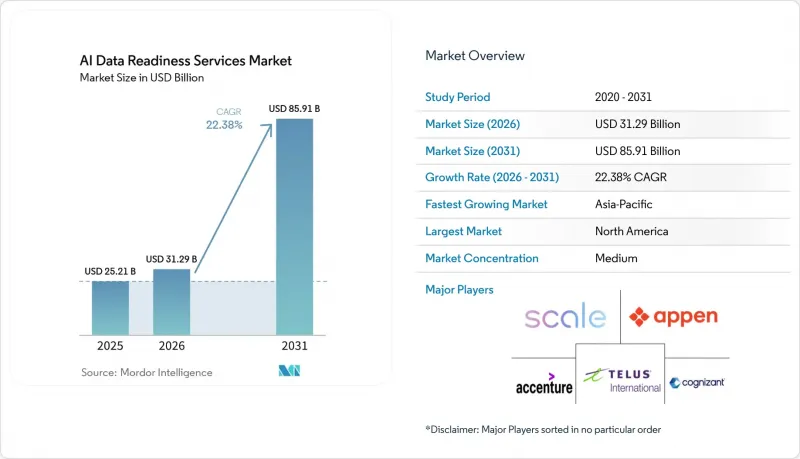
世界のAIデータ準備サービス市場の動向と洞察
企業のAI導入がパイロット段階から本番環境へ移行
パイロット段階から本番環境への移行は、AIデータ準備サービス市場の主要な促進要因となっています。これは、組織が業務システム、顧客とのやり取り、内部の意思決定、および従業員向けのナレッジツールを、信頼性と管理に関する通常のビジネス基準を満たす必要があるAI支援ワークフローに組み込んでいるためです。パイロットでは、限定的で前処理済みのデータセットで運用できますが、本番システムでは、多くの場合、異なる目的で作成され、別々のチームによって管理されている複数のビジネスアプリケーションからのデータを処理する必要があります。組織は、レガシーシステムを連携させ、機密性の高い記録を精査し、データ定義を整合させ、アクセスルールを設定し、導入後の品質を監視しなければなりません。これにより、孤立したモデル開発チーム内ではなく、データ環境全体にわたるデータ統合、データリネージの文書化、品質チェック、例外処理、および是正作業の必要性が高まっています。IBMは2026年1月、顧客がマルチクラウド環境全体で社内AIプラットフォームを構築、ガバナンス、運用できるよう支援する「Enterprise Advantage」を立ち上げましたが、これはガバナンスの行き届いた本番環境への移行という潮流を反映したものです。AIデータ準備サービス市場は、顧客がデータ準備を、モデルトレーニングの前に完了するプロジェクトとしてではなく、導入、更新、パフォーマンスレビュー、データ所有権の変更、および新しい使用事例の追加を通じて継続する運用要件として扱う場合に恩恵を受けます。
高品質なマルチモーダル学習データへの需要の高まり
AIデータ準備サービス市場は、同一のビジネスプロセス内でテキスト、画像、音声、動画、センサーデータにまたがるモデルの利用拡大によっても支えられています。これらのデータタイプは整合性を確保し、まとめて検証する必要があるため、テキストのみのモデル開発よりも広範な品質管理作業が発生します。また、多くの場合、チームは各レコードが作成された状況、各ラベルの出典、およびサンプルが保持された理由を理解する必要があります。チームは、ラベルが正確かどうか、ファイルが正しいイベントやオブジェクトに対応しているかどうか、異なるフォーマット間で定義が比較可能かどうか、そして意図した用途に対してカバレッジが十分かどうかを確認しなければなりません。CVPR 2026で発表された調査によると、視覚的に説得力のある合成画像であっても、微細なテクスチャのバリエーションが失われるため、質の低いトレーニングデータとなり得ることが判明しました。この結果により、モデルが実環境下で詳細な特徴を認識する必要がある場合、精選されたデータセットの代替として、未検証の合成データを使用することには限界があります。また、このことは、明確なポリシーと関連する専門知識に基づいて実施される、アノテーション、検証、サンプル選定、品質保証、レビュー手順、および文書化された例外処理への需要が引き続き高まることを意味します。
熟練したデータおよびドメイン専門家の不足
専門的な人材への需要は、AIデータ準備サービス市場における納期の遅延要因となり得ます。特に、プロジェクトが基本的なデータラベリング以上の作業を必要とする場合には、その傾向が強まります。医療記録、法務資料、工学コンテンツ、あるいは複雑な推論データなど、レビュー担当者が指示や不適切な分類がもたらす潜在的な結果だけでなく、その背景となる文脈も理解しなければならないタスクにおいては、一般的なラベリング能力だけでは不十分です。これらのタスクには、関連する分野を理解し、明確な方針を一貫して適用でき、例が意図された分類に適合しない場合を認識し、そのケースをエスカレーションすべき理由を説明できる人材が必要です。また、プロバイダーは、レビュー担当者の研修、品質チェックの維持、大規模なアノテーションプログラムにおける意見の不一致の解決、そして困難なケースがどのように処理されたかを説明する記録の保管も行わなければなりません。この要件は提供コストを押し上げ、需要が急増した場合や、多くのクライアントが同時に同様の専門スキルを求めるときには、対応能力を制限する可能性があります。そのため、専門家ネットワークを確立し、再現性のある品質管理プロセスを整備し、人間のレビューが最も重要なケースに専門家を割り当てるツールを保有している企業には、優位性が生まれます。
セグメント分析
2025年、「データクレンジング、変換、およびエンリッチメント」は、AIデータ準備サービス市場シェアの27.61%を占めました。モデルは、システム間で比較するまでは使用可能に見えるレコードを含め、誤ったデータ、重複したデータ、不完全なデータ、または一貫性のないデータを大規模に拡散させる可能性があるため、このサービスは必須のステップとなります。クライアントは、クレンジング作業を利用して、フィールドの標準化、エラーの修正、重複の削除、フォーマットの整合、欠損値の特定を行い、後の処理に向けたレコードの準備を行います。変換およびエンリッチメントは、ソースデータに有用な構造とコンテキストを追加し、下流のユーザーやアプリケーションが同一の項目を一貫して解釈できるようにします。クライアントが最新のクラウドプラットフォームを利用している場合でも、ソースレコードの品質、完全性、およびトレーサビリティが、結果として得られるデータセットが信頼性の高いAI使用事例をサポートできるかどうかを依然として決定づけるため、この作業は重要であり続けます。
データ統合、取り込み、およびエンジニアリング市場は、2031年までCAGR22.96%で拡大すると予測されています。エージェント型アプリケーションでは、単一のモデル実行用に準備された静的なデータセットではなく、複数のソースからの情報への信頼性の高いアクセスが必要となるため、チームはインターフェース、データ移動、アクセス権限、およびソースシステムの変更を管理しなければなりません。これにより、コネクタ、データパイプライン、スキーマの整合、メタデータ管理、品質チェック、およびアプリケーションが本番環境に移行した後も情報が利用可能な状態を維持するための継続的なエンジニアリングサポートに対する需要が高まっています。Databricksは2026年に、独自仕様のコードをオープンなANSI SQLに変換する「Genie Code」を導入し、プラットフォームプロバイダーがデータ移行や統合の特定の部分をいかに簡素化しているかを示しました。データ準備状況の評価とロードマップ策定、データディスカバリー、プロファイリング、品質評価、合成データの作成、ライセンシングに関する助言、および権利クリアランスのサポートにより、提供前および提供中に、カバレッジ、表現、ガバナンス、データの可用性、および許可された利用範囲におけるギャップを特定します。これにより、プロバイダーは、クライアントの変化する技術的および運用上のニーズに合わせて、診断作業、是正措置、および継続的な検証を順序立てて実施することが可能になります。
2025年、コンサルティングおよびアドバイザリーサービスは、AIデータ準備サービス市場の31.28%を占めました。企業は、必要なデータ状態の定義、システム全体の弱点の把握、最も重要なビジネス課題の優先順位付け、および是正措置開始前のガバナンスモデルの策定において、支援を必要とすることがよくあります。アドバイザリー業務は、多くの事業部門が関連データを保有しているもの、それぞれ異なる基準、プロセス、説明責任モデル、およびデータ品質の測定基準を採用している場合に特に重要です。プロバイダーは、運用要件をデータアーキテクチャ、ポリシー設計、プログラムの順序付け、および新しい慣行が採用されるかどうかを決定する変更管理のニーズと結びつけることができます。機能横断的にデータを共有する必要がある際に生じる所有権、ポリシー、資金調達、優先順位の決定は、技術的なツールだけでは解決できないため、このサービスモデルは依然として重要性を保っています。
「テクノロジー活用型サービス」は、2031年までCAGR23.42%で成長すると予測されています。ソフトウェアによるワークフローの導入により、プロバイダーは、純粋な手作業による提供よりも低い単位コストで、検証、ラベリング、品質管理、レビューの割り当て、および監査記録といった業務を、より大規模に処理できるようになります。IBMとGoogle Cloudは2026年6月、ハイブリッド環境全体でのガバナンス付きAI導入を実現するため、デリバリーツールとGemini Enterpriseの機能を組み合わせた戦略的「Google Cloud Practice」を発表しました。マネージド・サービスは、初期の準備プログラム完了後の継続的なデータ品質運用に対応する一方、自動化された事前ラベリングでは複雑なケースを確実に評価できなかったり、規制に準拠した意思決定を行えなかったりする場合には、ヒューマン・イン・ザ・ループ・サービスが依然として必要となります。AIデータ準備サービス業界では、クライアントが準備のさまざまな段階を経て、初期評価やガバナンス設計から長期にわたるモニタリング、修正、専門家によるレビューに至るまで、異なるレベルの継続的なサポートを必要とするため、アドバイザリーモデルとソフトウェア支援モデルの両方が維持される見込みです。
地域別分析
2025年、北米はAIデータレディネスサービス市場の37.71%を占めました。この地域では、テクノロジー企業や金融サービス企業による集中的なAI投資に加え、クラウドプロバイダー、専門ベンダー、研究機関、そしてシステムを初期テスト段階から、信頼性の高い統合と管理されたデータ運用を必要とするアプリケーションへと積極的に移行させている企業バイヤーからなる、成熟したエコシステムが形成されています。同地域の組織は、データ関連業務を本番環境でのAI導入に近づけており、ガバナンス、文書化、品質管理、統合、モデル評価、および既存のシステムと新しいクラウドベースのシステムの両方を含むことが多い複雑な技術環境全体にわたる一貫したワークフローに対する支援を必要としています。Scale AI社は、2025年に10億米ドルを超える新規データ事業の受注を報告し、米国国防総省から総額2億米ドル近くの契約を獲得したと発表しました。企業の需要と公共部門のプログラムが相まって、データ準備、評価、品質管理、ドメイン固有のレビュー、および大規模なデータセットを高付加価値の運用AIアプリケーションでより活用しやすくするサービスへの継続的な投資が支えられています。
アジア太平洋地域は、2031年までCAGR22.79%で成長すると予測されています。中国、インド、日本、韓国は、大規模なテクノロジー市場に加え、AI能力への官民投資、クラウド導入の拡大、そして地域のビジネスニーズや国家の技術優先事項を支えるための国内AI能力への関心の高まりを併せ持っています。同地域はAI需要の発生源であると同時に、アノテーションやデータ運用サービスの提供拠点でもありますが、クライアントは多言語モデルや地域固有のデータセットに対して、現地に即した言語、文脈、プライバシー慣行、ガバナンス手法、およびレビューポリシーを必要としています。同地域のAIデータ準備サービス市場は、クラウドの導入や企業におけるAI利用の拡大から恩恵を受ける可能性がありますが、地域ごとの規制が異なるため、プロバイダーにとっては、地域ごとの提供能力、現地のデータに関する知識、安全な運用、およびサービス慣行を適応させる能力が重要となります。
欧州は、AIデータ準備サービス市場において、地域別で第3位の規模を占めています。EU AI法がハイリスクAIシステムに対してデータガバナンスの実践を義務付けているため、同地域の需要はコンプライアンス主導の傾向にあります。企業は、対象となるシステムを開発する際に、データの出所、処理、およびバイアスに関する考慮事項についての証拠を準備しなければならず、これにより、文書化された品質およびガバナンスサービスへの需要が高まる可能性があります。中東は新興の成長地域であり、国家主導のAIプログラムにより、現地で管理され、権利処理が完了したデータに対する需要が生まれています。南米とアフリカは依然として初期段階の市場にとどまっています。AIへの関心が高い地域であっても、クラウドインフラの密度がサービス提供を制限する可能性があるためです。一方、ブラジルの公共部門のプログラムや南アフリカの金融サービス部門は、現地に適したサービスを提供する事業者にとって、より短期的なビジネスチャンスを提供しています。
その他の特典:
- エクセル形式の市場予測(ME)シート
- 3ヶ月間のアナリストによるサポート
よくあるご質問
目次
第1章 イントロダクション
- 調査の前提条件と市場の定義
- 調査範囲
第2章 調査手法
第3章 エグゼクティブサマリー
第4章 市場情勢
- 市場概要
- 市場促進要因
- 企業におけるAIの導入が、パイロット段階から本番運用へと移行しています
- 高品質なマルチモーダル学習データへの需要の高まり
- 生成AI、エージェント型AI、および基盤モデルの拡大
- 追跡可能かつ管理されたデータに対する規制上のニーズの高まり
- モデルの失敗に関するフィードバックが、継続的なデータ改善の需要を生み出しています
- 特定分野に特化し、権利処理済みのデータ資産の不足
- 市場抑制要因
- 熟練したデータ専門家および分野専門家の不足
- データプライバシー、主権、および国境を越えたデータ移転の制限
- 合成データおよび人間が作成したトレーニングデータの所有権の不明確さ
- モデルやプロバイダーをまたぐラベル・ポリシーの移植性の低さ
- マクロ経済要因が市場に与える影響
- 業界バリューチェーン分析
- 規制情勢
- 技術展望
- ポーターのファイブフォース分析
第5章 市場規模と成長予測
- サービスタイプ別
- データ準備状況の評価とロードマップ策定
- データディスカバリー、プロファイリング、および品質評価
- データのクリーニング、変換、およびエンリッチメント
- データ統合、取り込み、およびエンジニアリング
- その他のサービスタイプ
- 提供モデル別
- マネージドサービス
- コンサルティング・アドバイザリーサービス
- テクノロジーを活用したサービス
- ヒューマン・イン・ザ・ループ・サービス
- その他の提供モデル
- 展開モデル別
- クラウド
- オンプレミス
- ハイブリッド
- 組織規模別
- 中小企業
- 大企業
- エンドユーザー産業別
- IT・通信
- 銀行・金融サービス・保険
- ヘルスケア・ライフサイエンス
- 自動車・輸送産業
- 小売・Eコマース
- 製造・産業
- エネルギー・ユーティリティ
- その他のエンドユーザー産業
- 地域別
- 北米
- 米国
- カナダ
- メキシコ
- 南米
- ブラジル
- アルゼンチン
- コロンビア
- その他の南米諸国
- 欧州
- 英国
- ドイツ
- フランス
- イタリア
- ロシア
- その他の欧州諸国
- アジア太平洋
- 中国
- 日本
- インド
- 韓国
- オーストラリア
- シンガポール
- その他のアジア太平洋諸国
- 中東
- アラブ首長国連邦
- サウジアラビア
- イスラエル
- トルコ
- その他の中東諸国
- アフリカ
- 南アフリカ
- ナイジェリア
- エジプト
- ケニア
- その他のアフリカ諸国
- 北米
第6章 競合情勢
- 市場集中度
- 戦略的動向
- 市場シェア分析
- 企業プロファイル
- Appen Limited
- Scale AI, Inc.
- TELUS Digital International Inc.
- Cognizant Technology Solutions Corporation
- International Business Machines Corporation
- Accenture plc
- Amazon Web Services, Inc.
- Microsoft Corporation
- Google LLC
- Labelbox, Inc.
- CloudFactory Limited
- SamaSource, Inc.
- DataLoop Ltd.
- SuperAnnotate AI, Inc.
- Encord Inc.
- Snorkel AI, Inc.
- iMerit Technology Services Pvt. Ltd.
- Toloka AI B.V.
- RWS Holdings plc
- TransPerfect Translations International, Inc.
- Lionbridge Technologies, LLC
- Qualitest Group
- Technology Platforms International, Inc.
- Oracle Corporation
- Snowflake Inc.
- Databricks, Inc.